政企数据资产化管理新趋势:数据采集与智能分析的协同实践
过去一年,政企市场对数据资产化的讨论,正从“要不要做”转向“怎么做才不踩坑”。一个肉眼可见的趋势是:单纯堆砌采集节点或采购昂贵分析平台的时代已经过去,取而代之的是**将数据采集的“物理触角”与智能分析的“决策大脑”进行深度耦合**。这种协同不是IT项目的简单拼接,而是触及组织数据治理底座的系统性重塑。
现象:采集端“烟囱林立”,分析端“无米下炊”
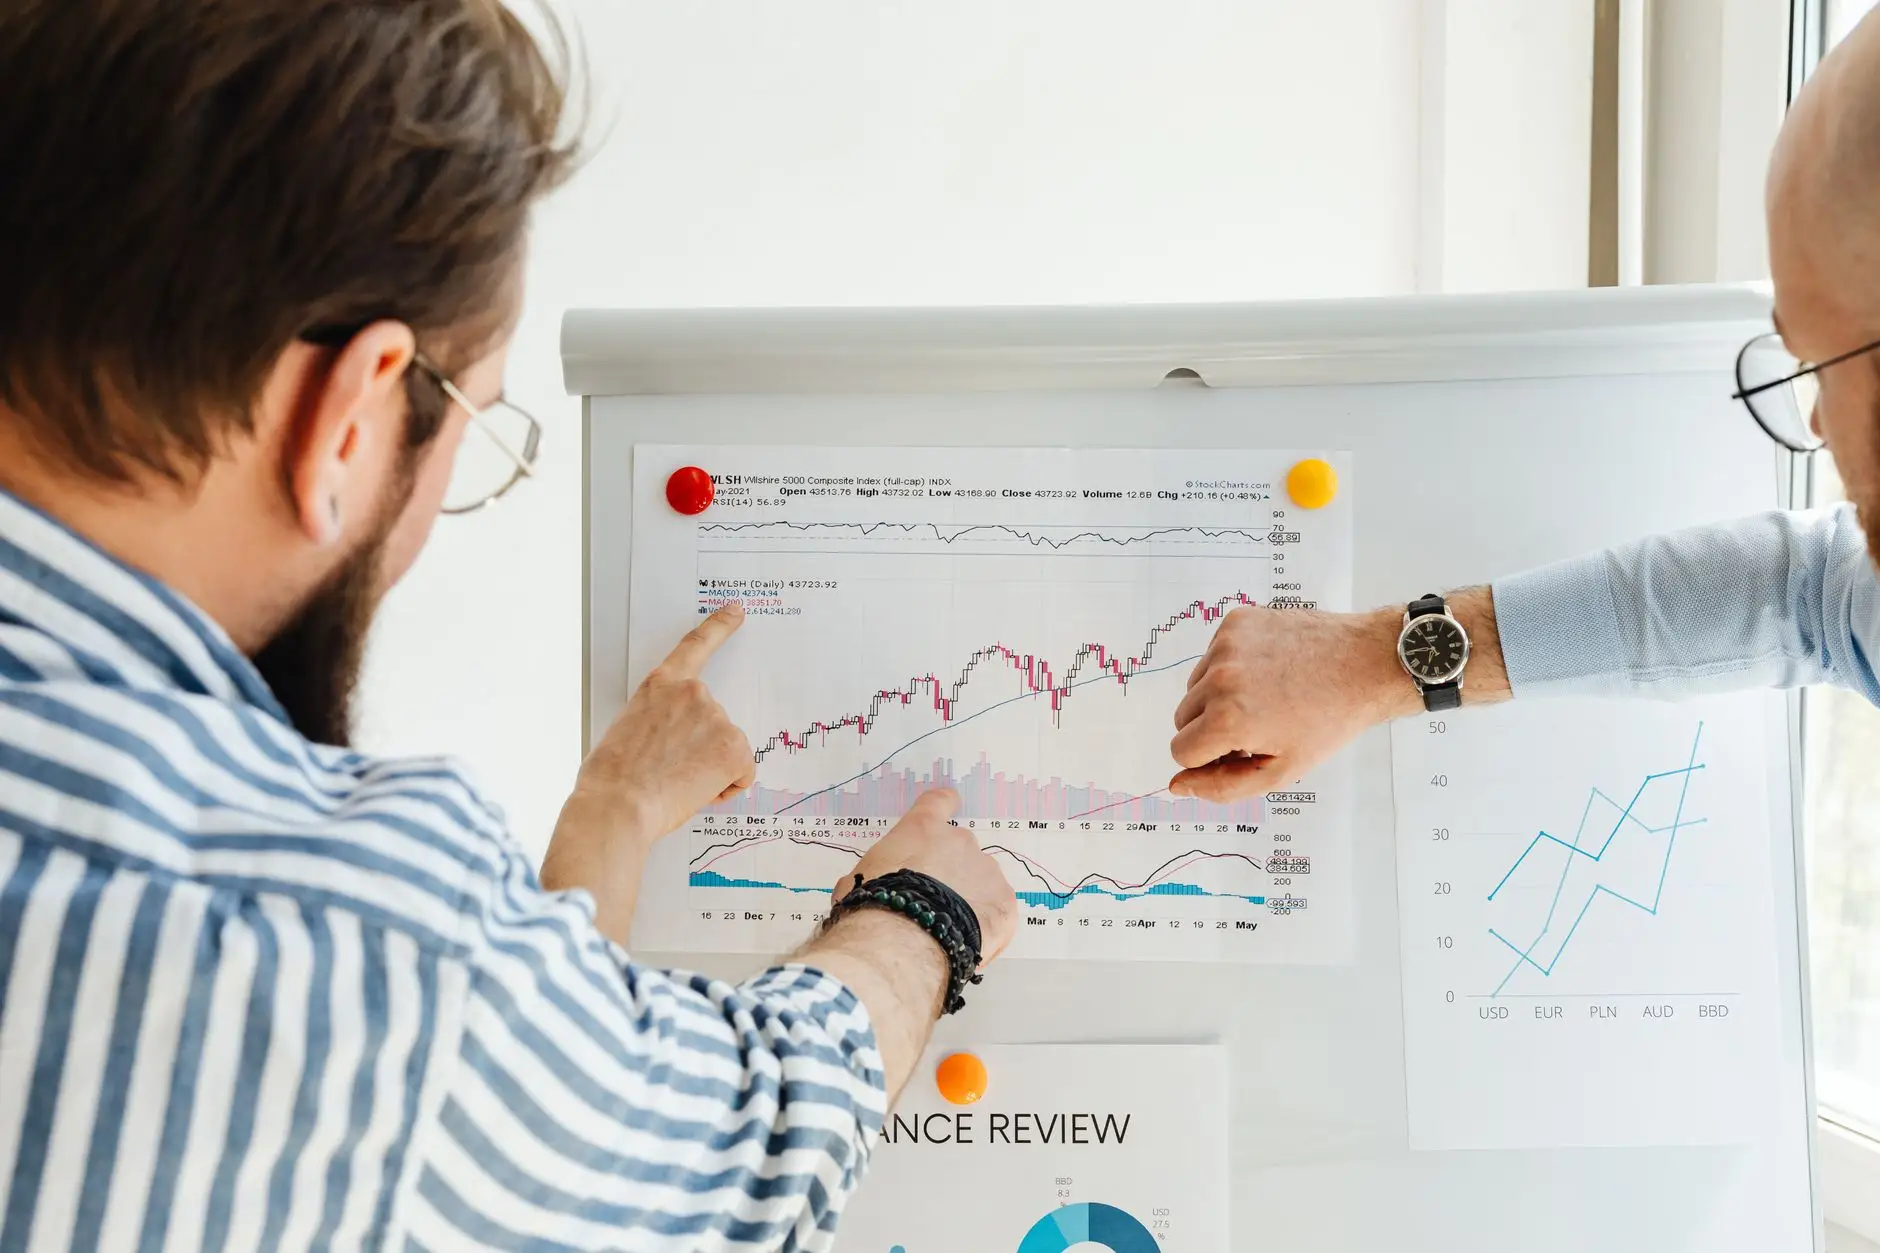
不少政务云和大中型国企的数据团队都遇到过类似的尴尬:业务部门抱怨报表出得慢、分析结论“不解渴”;而技术部门则满腹委屈——底层几十套业务系统的数据接口调了又调,每天新增的数据量高达几个TB,但真正进入分析环节的数据,往往不足采集总量的5%。问题出在哪?大量精力耗费在应对接口变动、清洗重复字段、处理脏数据上,数据采集链路本身缺乏智能化的元数据管理与质量预校验机制。采集上来的数据,如同未经分拣的矿石,品位低、杂质多,后续的智能分析自然成了“戴着镣铐跳舞”。
原因深挖:数据资产化的“乘数效应”被割裂
深究根源,是很多政企单位将数据采集和智能分析当作两个独立的预算科目来管理。采集归口在信息中心或云厂商,分析则归口在业务处室或大数据局。这种组织边界直接导致技术逻辑上的脱节——采集策略不服务于分析目标,分析模型又不了解采集端的字段口径与时效约束。数据资产化的本质是追求“数据要素×场景价值”的乘数效应,而当采集与分析各自为政时,这个乘号就变成了除号,数据治理沦为一句空话,再强大的算法模型也喂不出高质量的大数据洞察。
技术解析:协同实践的三个关键支点
要打破僵局,北京数字科智在服务多家部委及省属企业的实践中,提炼出三条可落地的协同路径,供行业参考:
- 智能感知型采集策略:在采集端引入轻量级流式计算框架,对数据源进行实时轮廓分析(Profiling),自动识别字段漂移、空值率异常及业务主键冲突。这不再是传统的“定时抽取”,而是让采集具备自我感知能力,从源头降低分析前的治理成本。
- 面向分析的存储编排:放弃“数据湖里存原始数据、数仓里存汇总数据”的僵化分层,改为基于分析场景的冷热数据自动编排。例如,针对领导驾驶舱的高频查询,采用列式存储与内存索引;针对离线挖掘任务,则转入高压缩比的湖存储。这种动态编排让数据服务响应时间平均缩短40%以上。
- 知识图谱驱动的元数据打通:将散落在各业务库中的数据字典、接口文档、报表口径,统一构建为机器可读的知识图谱。当分析人员拖拽一个“常住人口”字段时,系统能自动关联其采集源头、清洗规则及历史版本变更,数据血缘清晰到字段级。
这套协同逻辑的核心,在于将数据治理的动作前置到采集发生的那一刻,而不是等数据进入分析平台后再进行“亡羊补牢”式的清洗。以我们服务过的某沿海城市应急管理局为例,过去其危化品监管平台接入的物联网传感器数据,误报率常年徘徊在15%左右。通过上述策略调整后,采集端增加了基于时间序列的异常抖动过滤模型,误报率降至2%以下,同时智能分析模型终于能基于干净的数据流,提前4小时预测出特定区域的泄漏风险。
对比分析:传统模式与协同模式的本质差异
传统模式下,数据服务往往以“项目交付”为终点,系统上线即意味着技术团队撤场,后续的数据质量运维无人问津。而协同实践下的数据服务,更像是一种“持续运营”的机制——采集策略根据分析模型的反哺效果动态调优,分析结果又反过来指导采集资源的投放重点。这不仅是技术栈的升级,更是从“被动响应需求”向“主动定义数据资产价值”的思维转变。后者对组织的数据素养要求更高,但带来的决策时效性提升,往往是数量级上的。
给政企同行者的三条务实建议
基于过往项目的经验教训,如果想推动本单位的数据资产化走向深水区,不妨从以下三件事入手:
- 先选一个高频痛点场景做穿透式改造,比如“一网通办”中的材料预审环节,打通采集与NLP分析模型,见效周期控制在6周内,便于向管理层证明协同价值。
- 重构技术团队的考核指标,不要再单看“采集了多少亿条数据”,而要考核“高质量数据供给率”和“分析模型上线后的业务采纳率”。
- 在采购合同中明确“数据治理运营”的长期服务项,避免将数据采集和智能分析分包给两家毫无沟通机制的中标方。
数据资产化的下半场,比的不是谁家服务器多、算法炫,而是谁能在数据采集的“最后一公里”和智能分析的“最初一公里”之间,架起一条高效、合规且可持续的协同高速公路。这条路没有捷径,但每一步都算数。